言語・視覚知能
大規模言語モデル、視覚言語モデル、マルチモーダル理解と効率的なAIの研究。

機械学習,知覚,インタラクションを人間や社会のニーズに結び付けます.研究分野から具体的なプロジェクト,動画による実演までをご紹介します.
大規模言語モデル、視覚言語モデル、マルチモーダル理解と効率的なAIの研究。
可搬型センシング、プローブ追跡、超音波の3次元再構成。
検出、セグメンテーション、人物再識別と追跡中のID整合性。
非接触センシング、レーダによる知覚と人間活動の解析。
没入型体験、空間ディスプレイ、視線追跡と人間中心設計。
産業界、大学、地域社会と協働する実践的な技術開発。
医療,人物追跡,視覚検査,センシング,没入型体験などを対象に,理論と実験を往復しながら進める研究を紹介します.
二つのロータリーエンコーダによるプローブ追跡と3次元再構成。
研究資料を見る ↗人物再識別におけるドメイン適応とアンサンブル融合。
研究資料を見る ↗キューブ型とライトフィールドディスプレイを用いた知覚評価。
研究資料を見る ↗食品画像に含まれる微小欠陥のセグメンテーションと検出。
研究資料を見る ↗ミリ波による人体センシングと複数センサの統合。
3次元のインタラクティブ体験と人間中心のシステム開発。
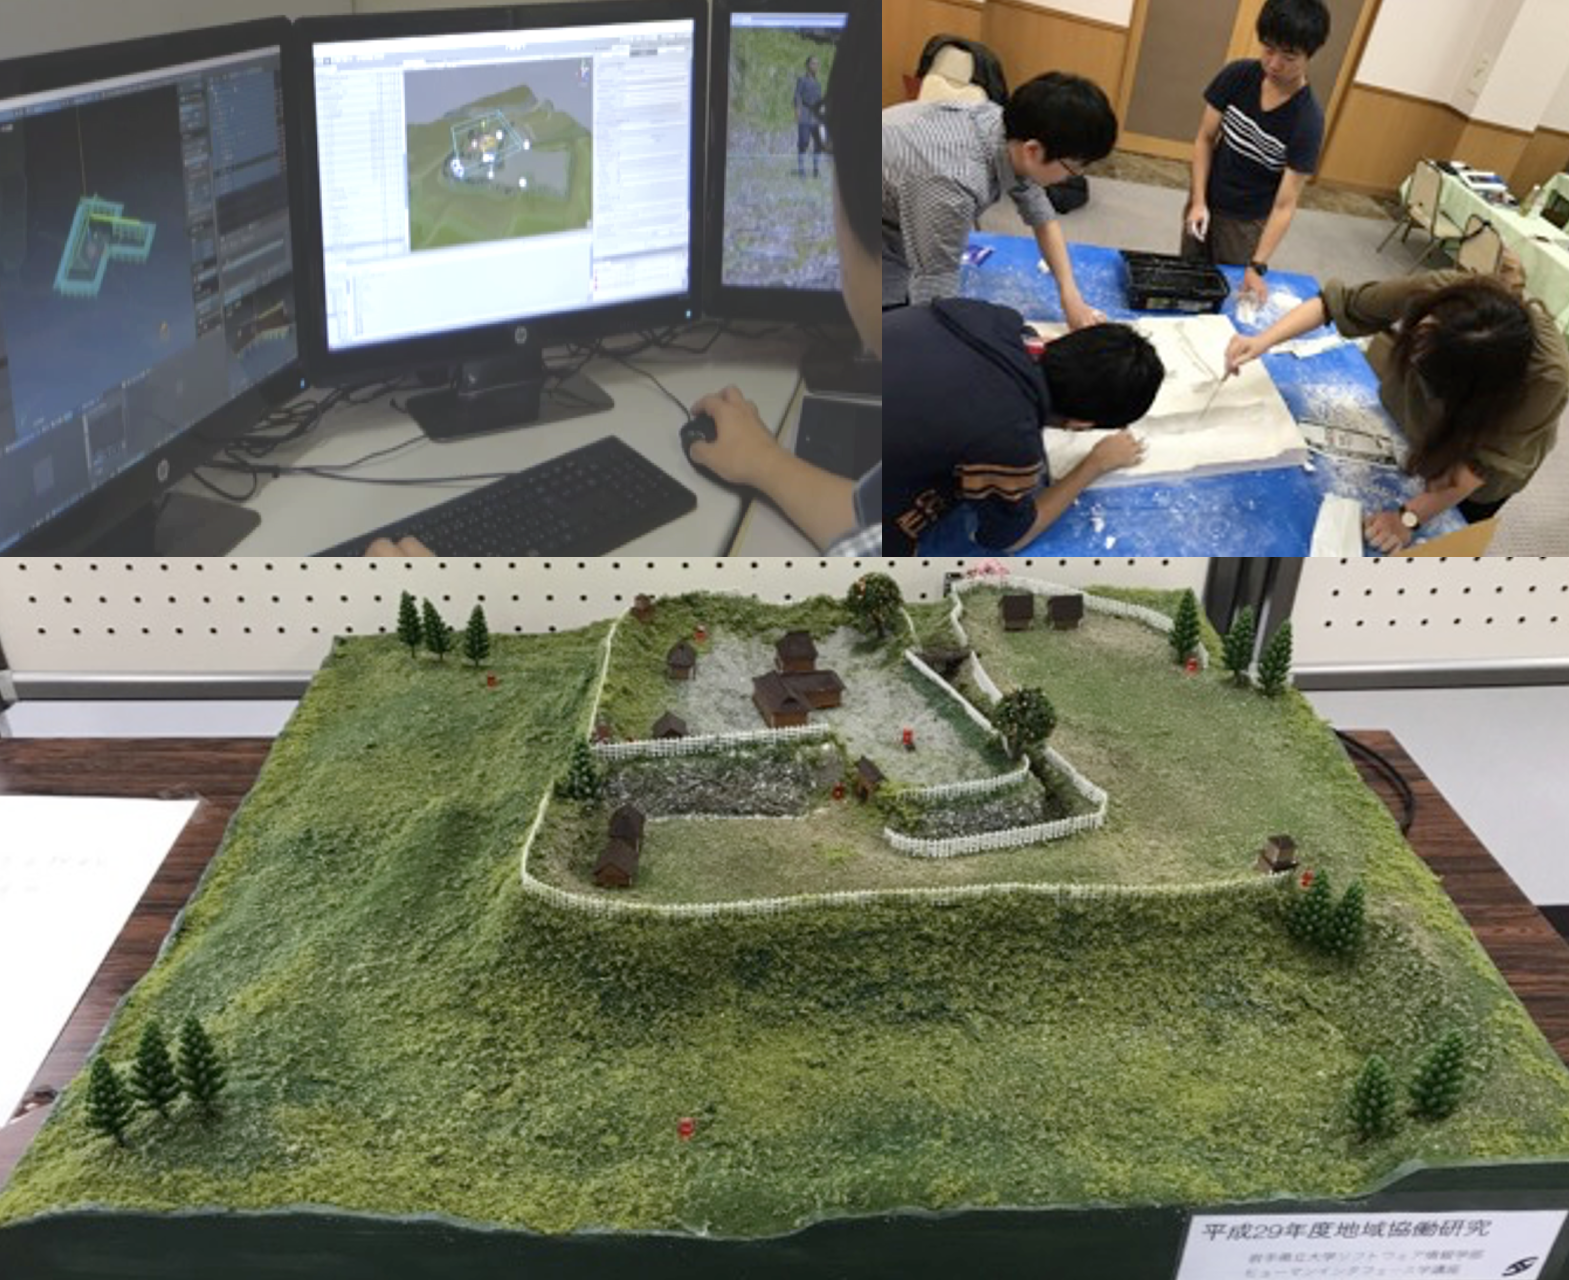
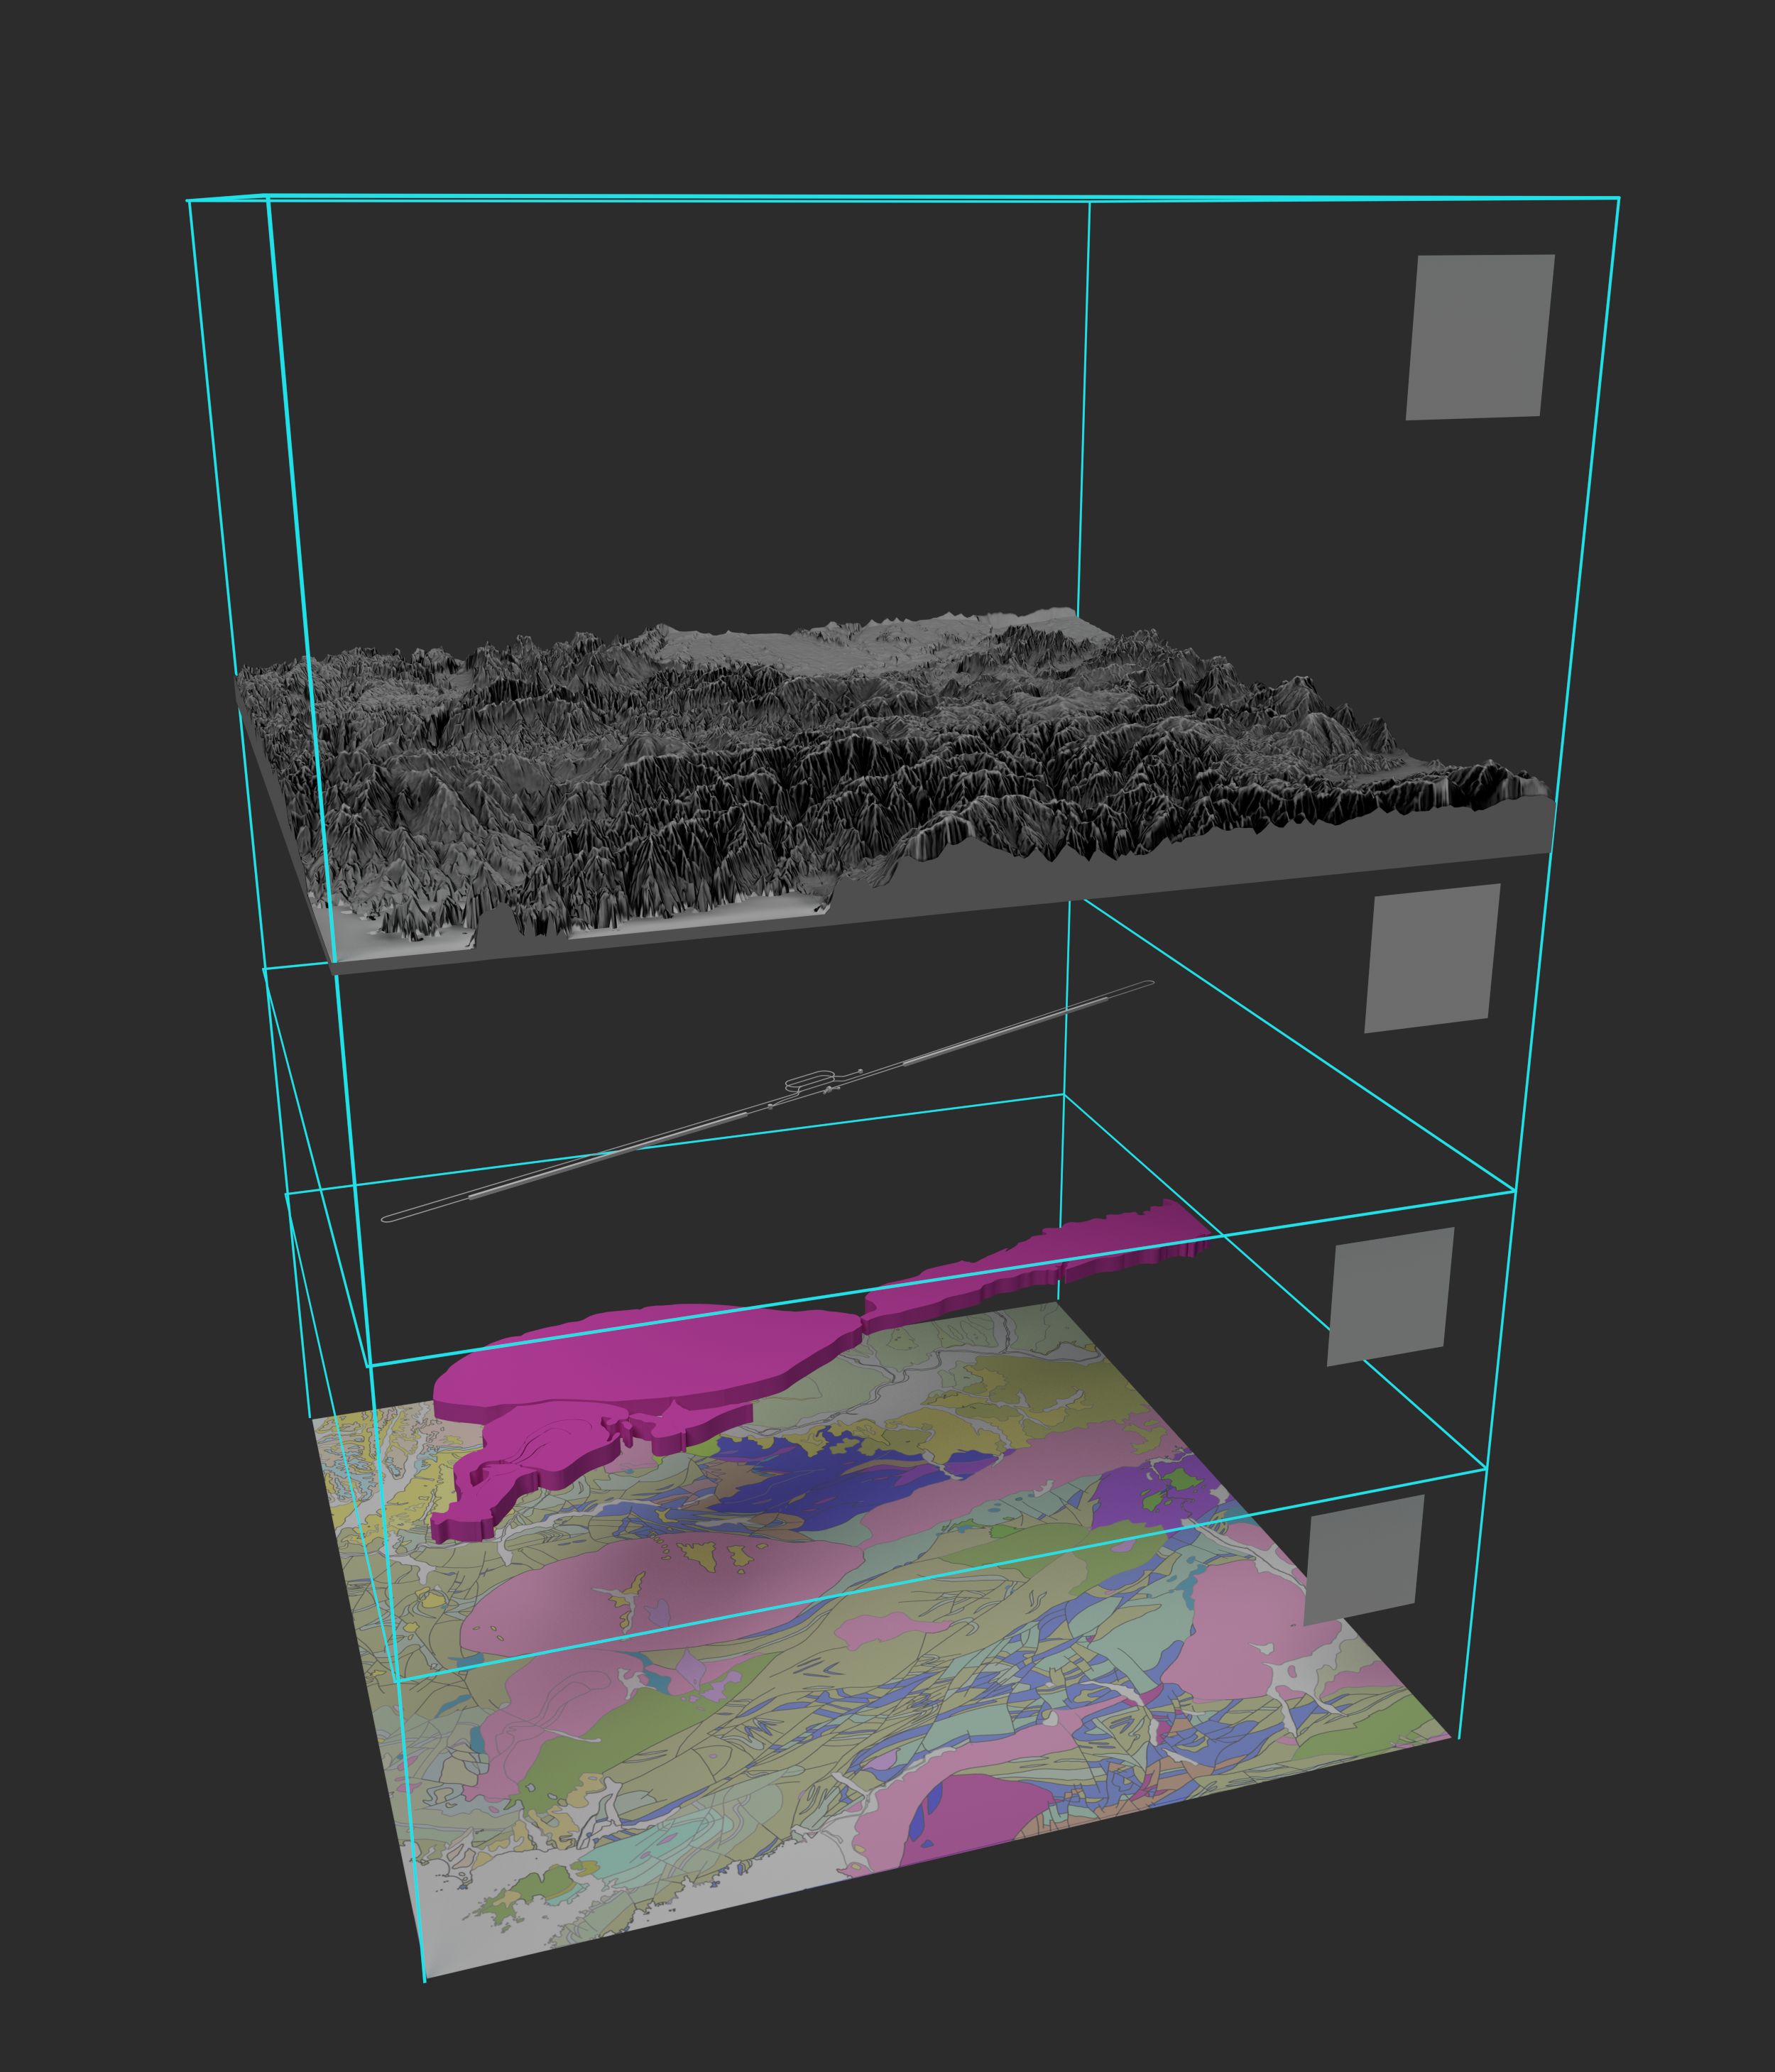
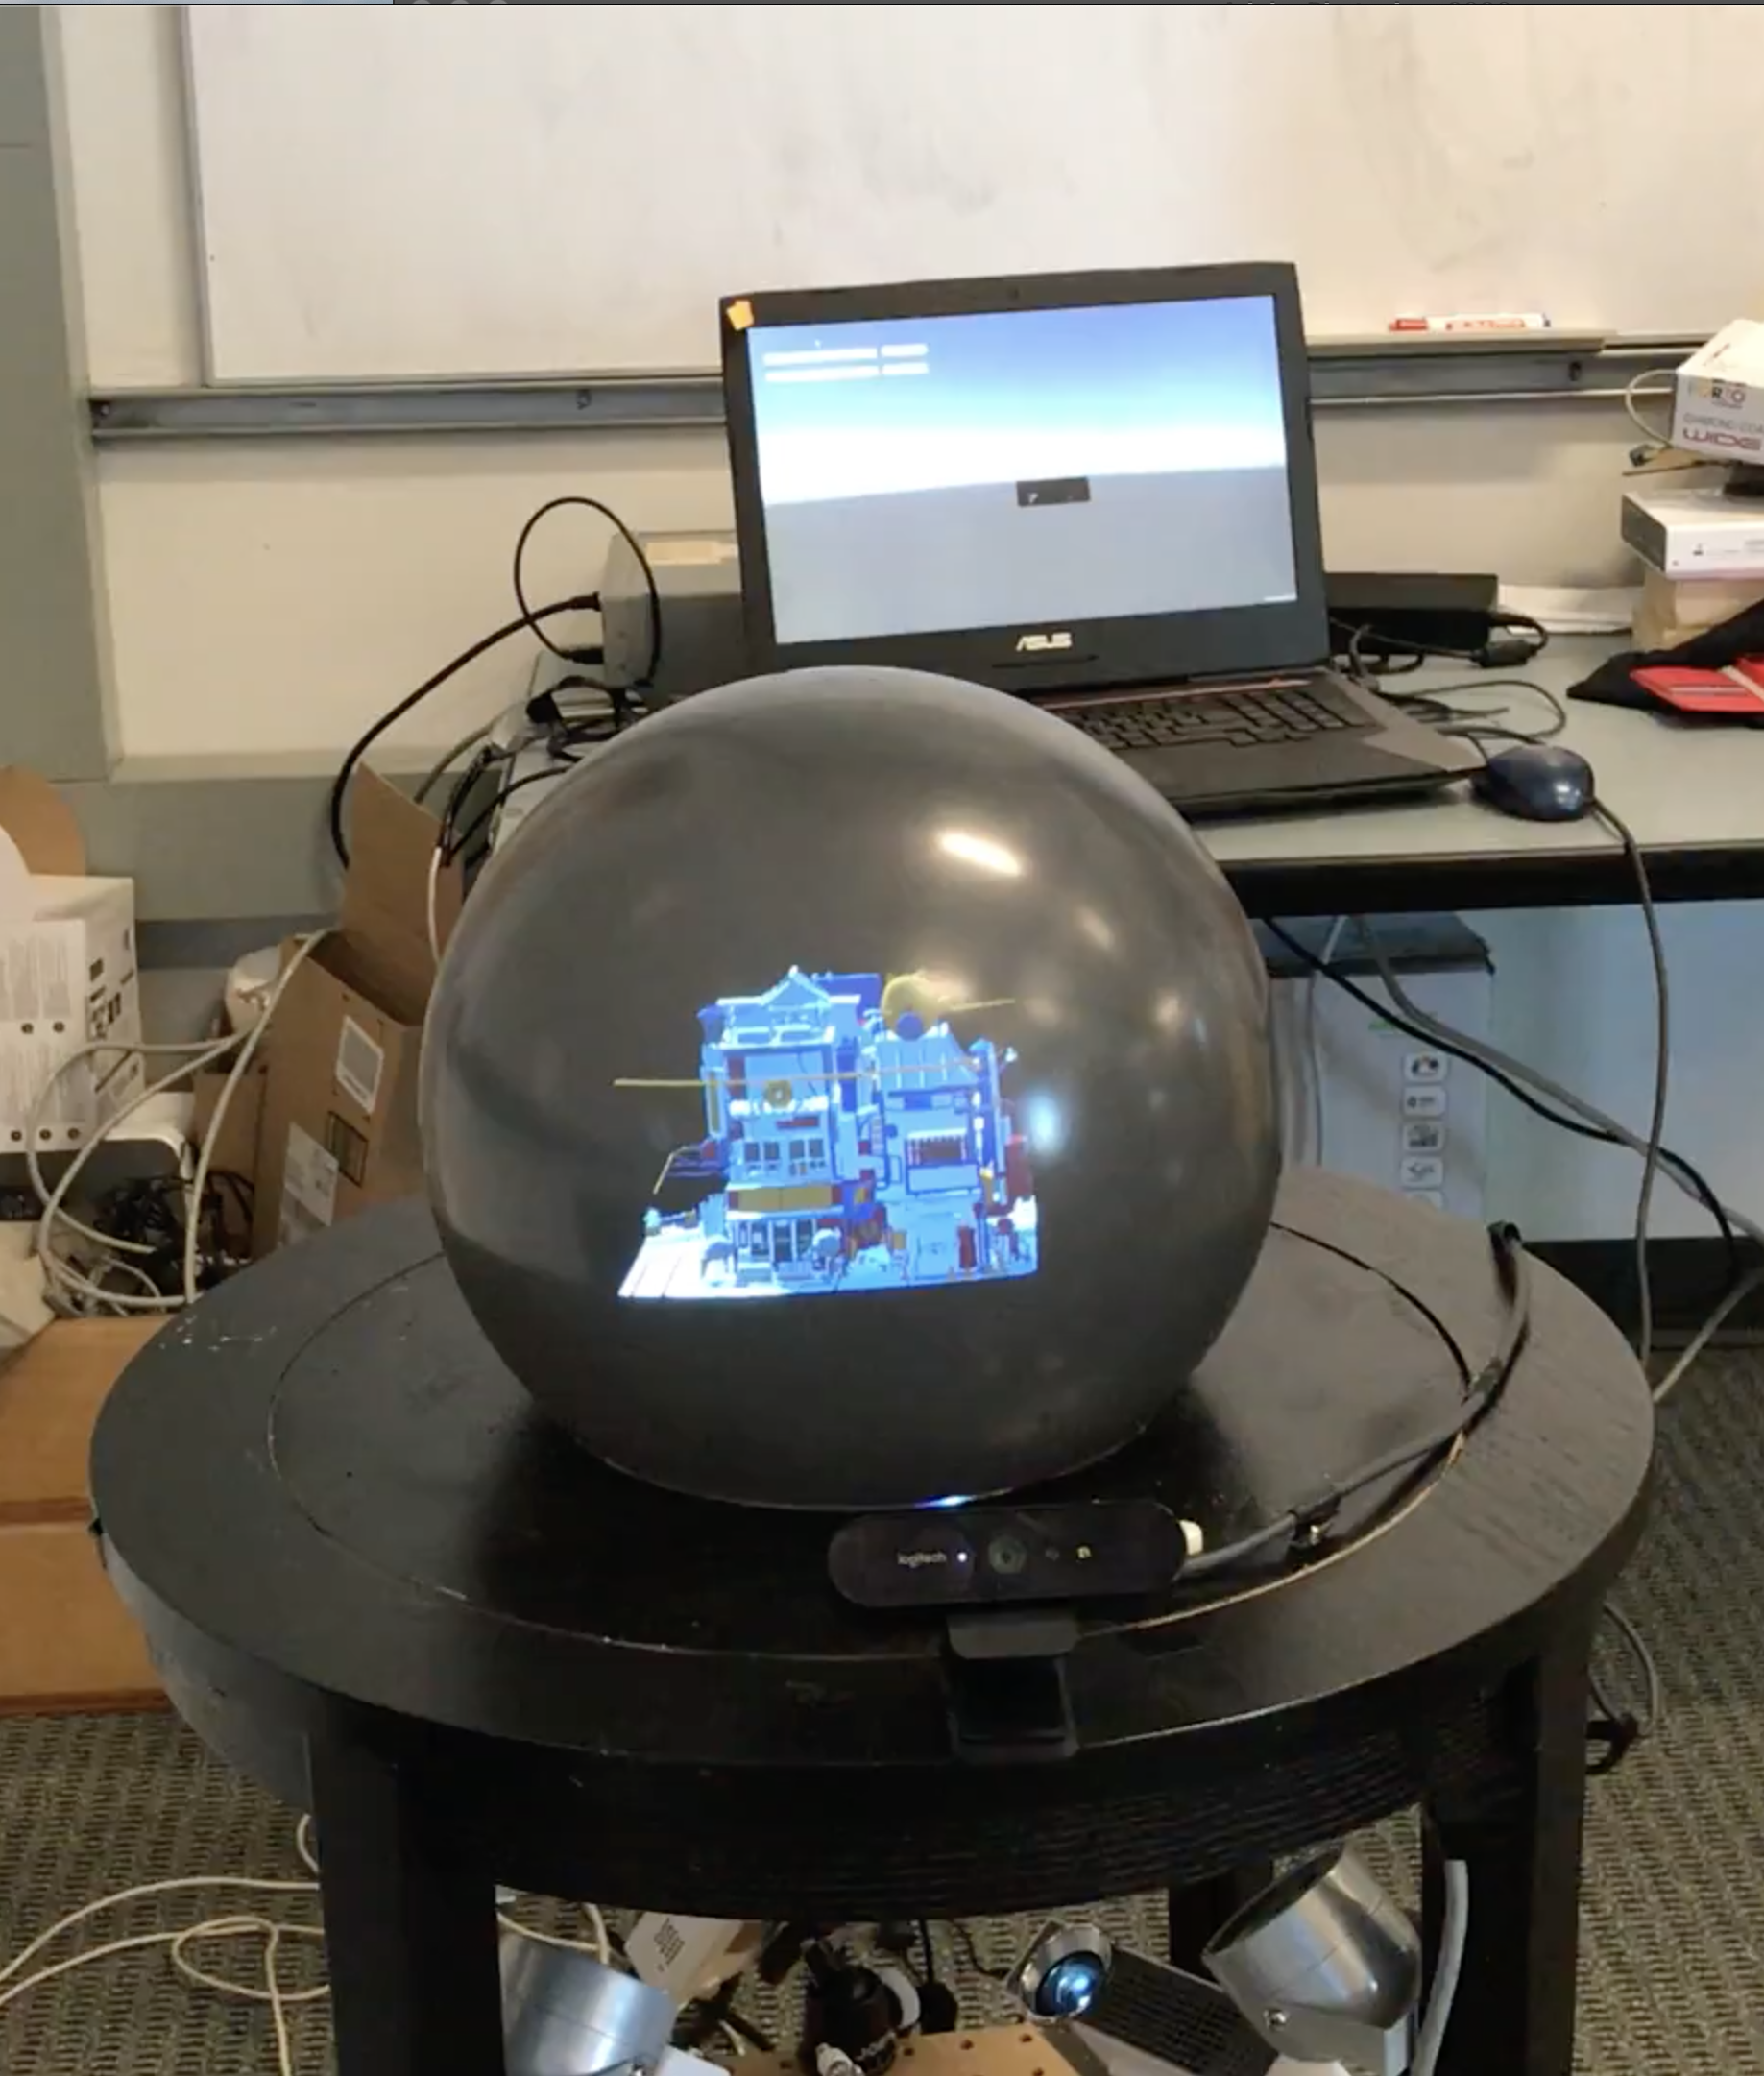
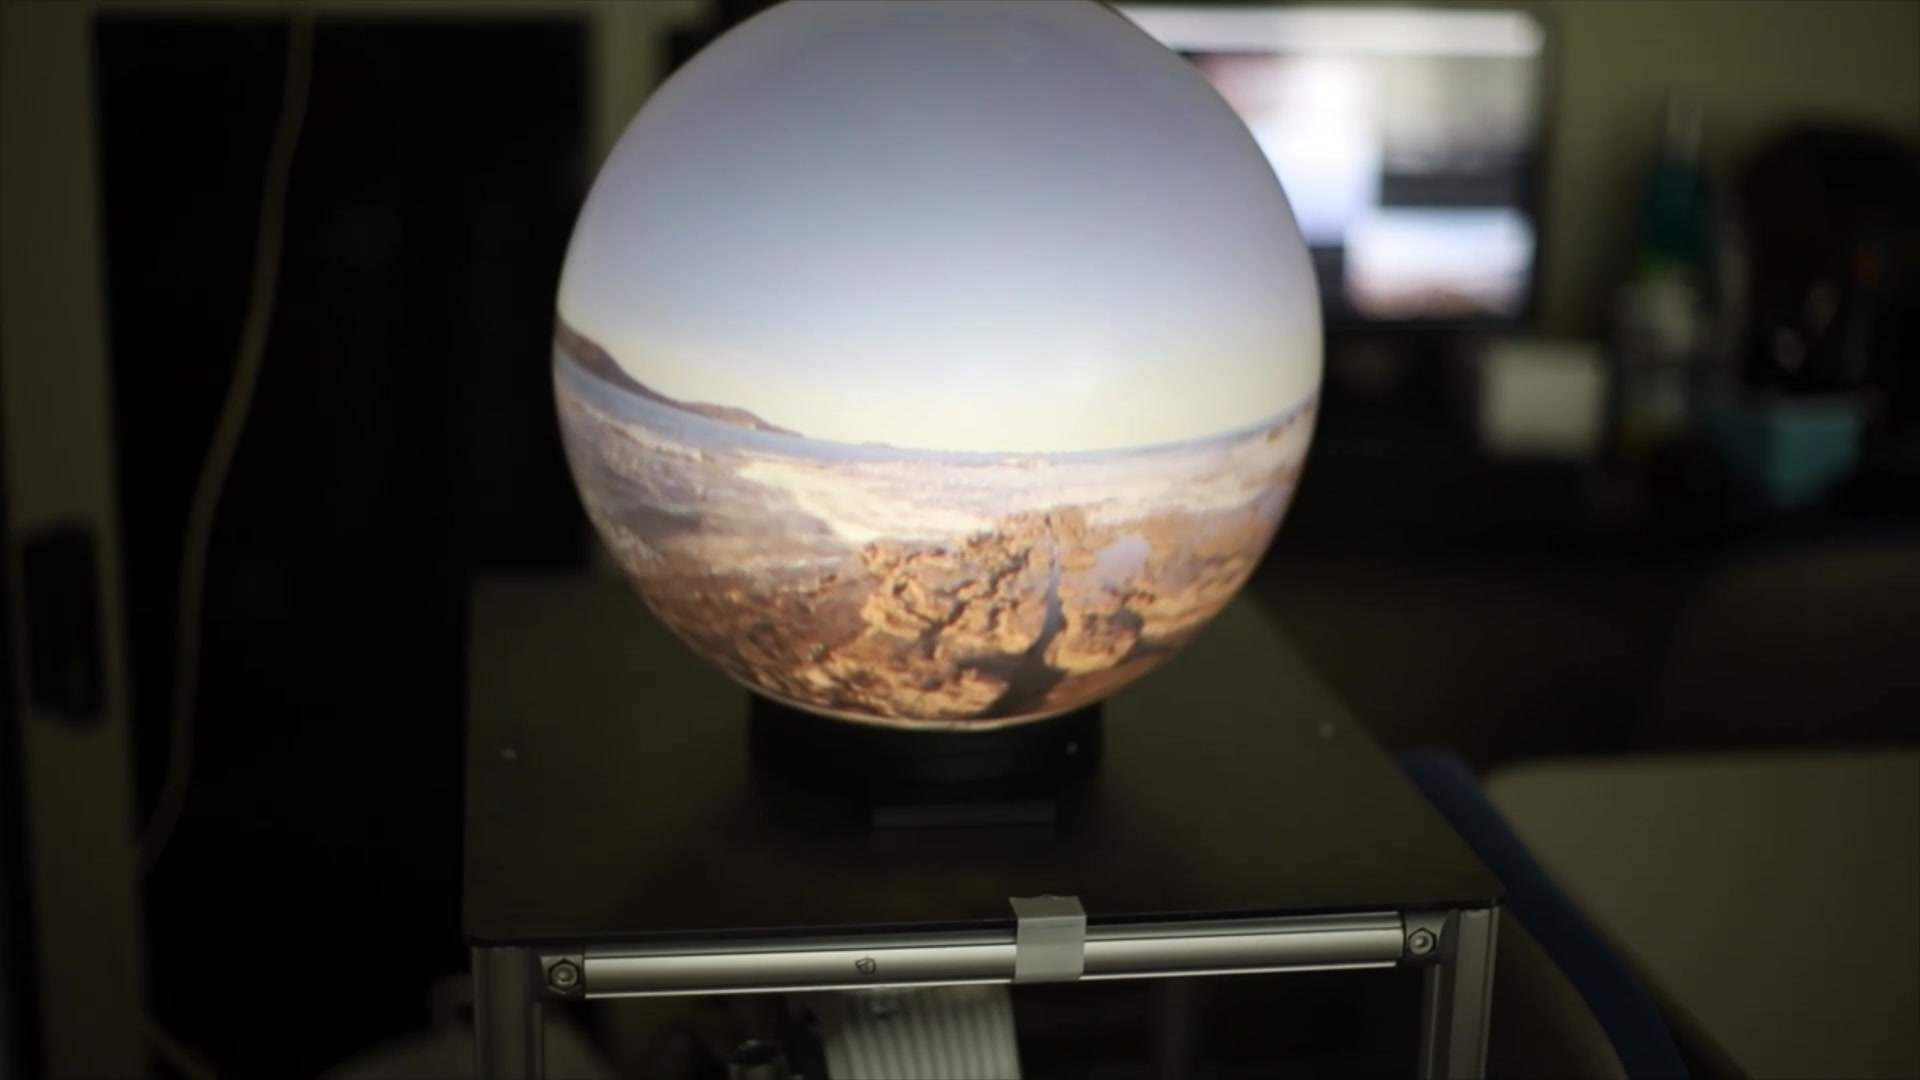
九戸城のVR復元,ILC構想の可視化,球体型3DディスプレイSpheriCulの開発など,立体映像を人間の体験につなげる研究です.以下は旧SpheriCulサイトで実際に使われている4本のアニメーションです.
映像:旧SpheriCulサイトの公開アニメーション.再生ボタンを押すと映像を確認できます.