①
見た目の違いを学ぶ
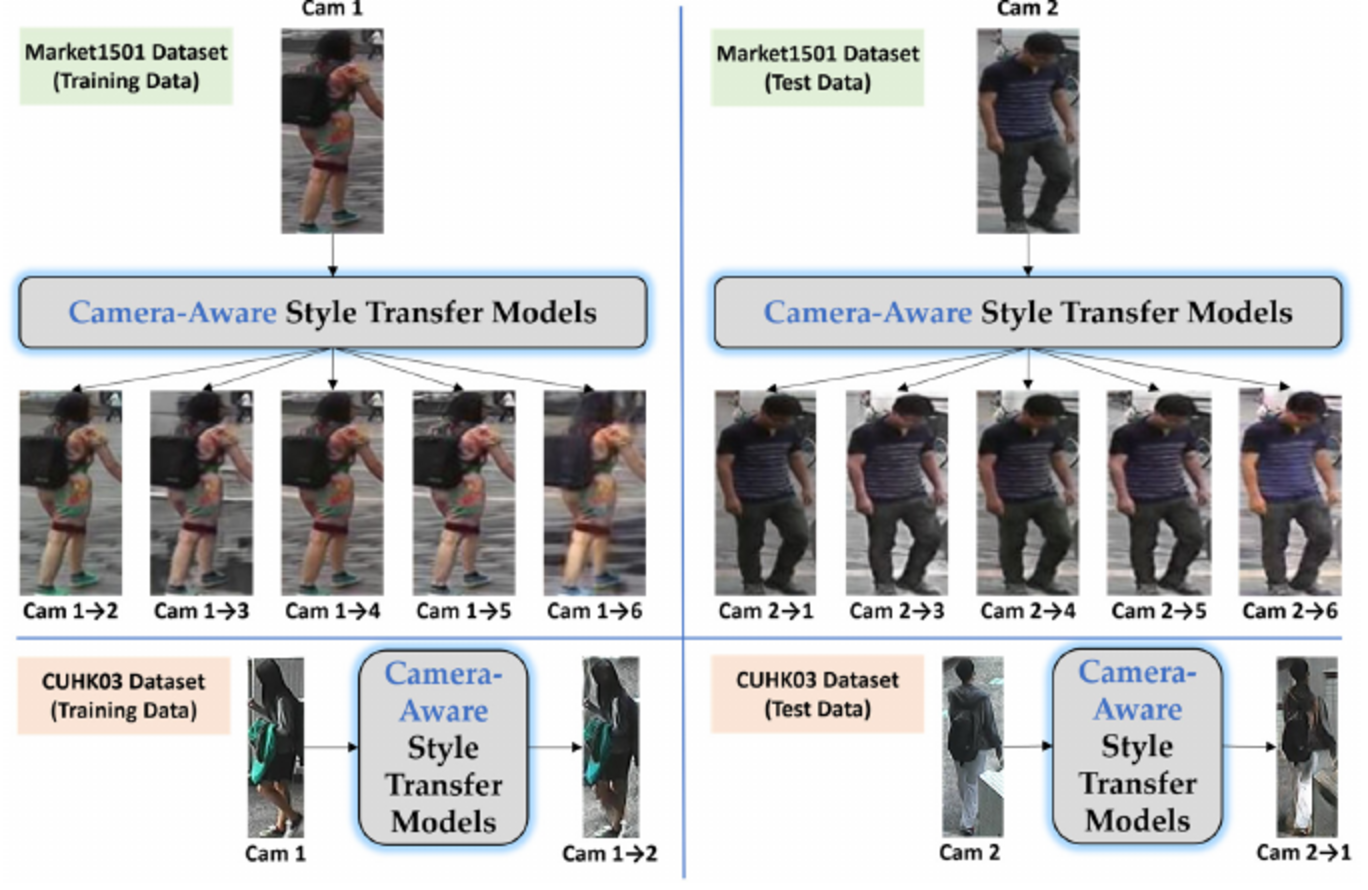
CycleGANによるスタイル変換で,異なるカメラや撮影環境に近い画像を生成し,学習データを多様化します.

CORE-ReID V2 — 人物や車両の「同一性」を,異なる撮影環境を越えて認識するAI技術.
撮影場所・照明・カメラの違いによる見た目の変化に対応し,対象を再び識別する「Re-Identification(再識別)」の精度を高める研究です.
同じ人物や車両でも,カメラが変われば色味,明るさ,画角,背景が大きく変化します.ある環境で学習したAIを別の環境で使うと,識別精度が低下しがちです.
さらに,新しい現場で一人ひとり,一台ごとに正解ラベルを付け直すには,多くの時間と労力が必要です.
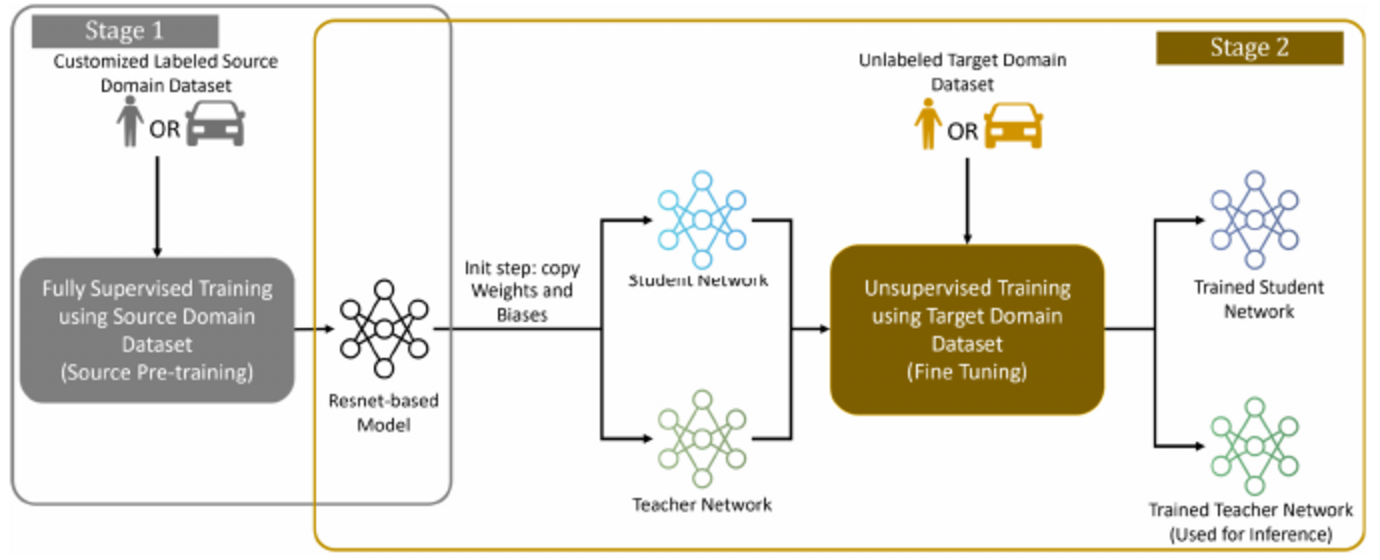
CORE-ReID V2は,既知の画像で特徴の捉え方を学んだ後,ラベルのない新しい環境の画像から適応を進めます.
CycleGANによるスタイル変換で,異なるカメラや撮影環境に近い画像を生成し,学習データを多様化します.
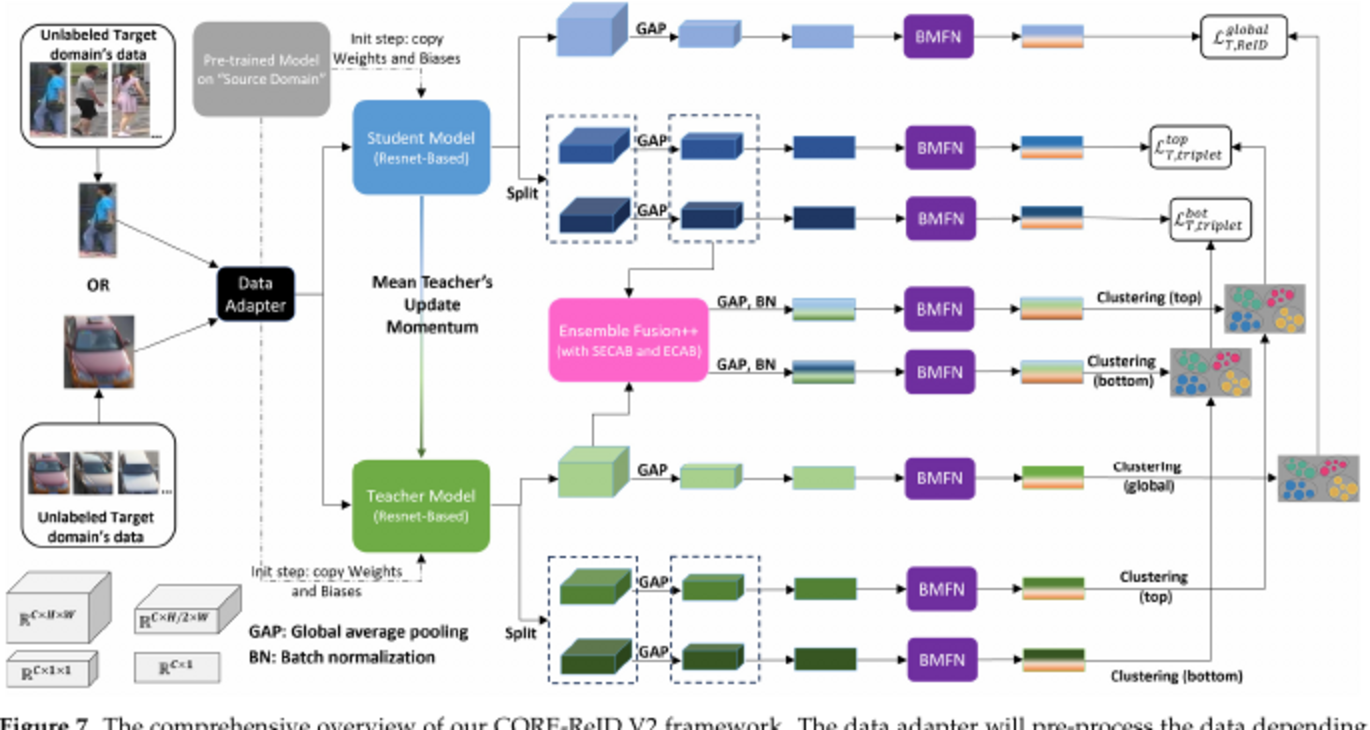
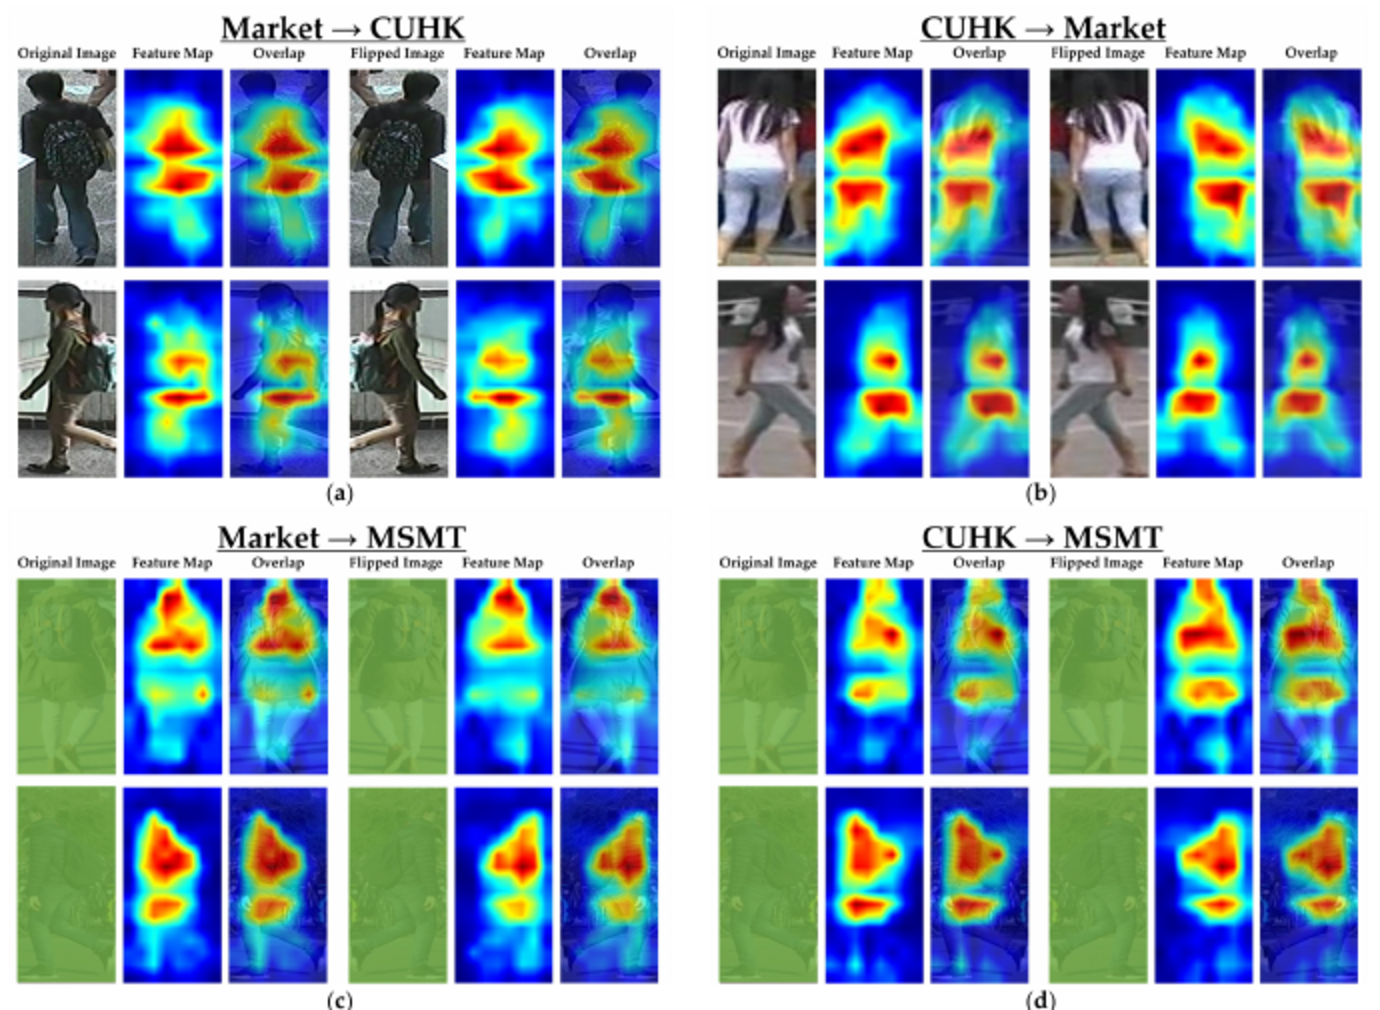
全体の特徴と部分的な特徴を組み合わせ,ECABと新たなSECABによる注意機構で識別に役立つ情報を強めます.
類似画像のクラスタリングから仮のラベルを作り,教師・生徒モデルで新しい環境への学習を進めます.
| 構成・技術 | 目的と役割 |
|---|---|
| 事前学習 | 正解ラベル付きの元データで特徴抽出モデルを学習 |
| CycleGAN | 画像の撮影スタイルを変換し,学習データの多様性を向上 |
| ECAB + SECAB | 局所特徴と全体特徴に注意を向け,識別に役立つ情報を強調 |
| クラスタリング | K-means++によりラベルのない画像に仮のIDを割り当てる |
| Mean Teacher | 生徒・教師ネットワークで仮ラベルを利用した学習を安定化 |
| バックボーン | ResNet18 / 34 / 50 / 101 / 152に対応 |
画像の見た目を変えて学習を強くする工夫と,AIが識別時にどこを重視しているかを示した論文図です.
| 対象 | データセット | 特徴 |
|---|---|---|
| 人物 | Market-1501 | 6台のカメラで撮影した人物画像 |
| 人物 | CUHK03 | 複数カメラによる人物画像 |
| 人物 | MSMT17 | 15台のカメラ,照明や時間帯の変化が大きいデータ |
| 車両 | VeRi-776 | 20台の監視カメラによる車両画像 |
| 車両 | VehicleID / VERI-Wild | 車両を異なる環境で照合するベンチマーク |
出典:論文 Table 3.データセット間で学習時と評価時の撮影環境を変えて検証しています.
人物再識別と車両再識別の代表的な公開データセットで評価しました.以下はmAP(平均適合率)という,検索結果全体の正確さを測る指標です.値が高いほど良好です.
| 学習 → 評価データ | 旧CORE-ReID | CORE-ReID V2 | 改善幅 |
|---|---|---|---|
| Market → CUHK | 62.9% | 66.4% | +3.5 pt |
| CUHK → Market | 83.6% | 84.5% | +0.9 pt |
| Market → MSMT | 41.9% | 44.1% | +2.2 pt |
| CUHK → MSMT | 40.4% | 40.7% | +0.3 pt |
出典:論文 Table 4・5.指標はmAP(%),改善幅はパーセントポイント.
| 学習 → 評価データ | 評価条件 | mAP | Rank-1 |
|---|---|---|---|
| VehicleID → VeRi-776 | 標準 | 49.50% | 80.15% |
| VehicleID → VERI-Wild | Test3000 | 40.2% | 76.6% |
| VehicleID → VERI-Wild | Test5000 | 34.9% | 70.2% |
| VehicleID → VERI-Wild | Test10000 | 27.8% | 62.1% |
| VeRi-776 → VehicleID | Test800 | 67.04% | 58.32% |
出典:論文 Table 6–8.mAPは検索候補全体の精度,Rank-1は最上位候補が正しい割合を示します.評価条件が異なる値は直接比較できません.
各数値は公開ベンチマークにおけるドメイン適応実験の結果であり,一般環境での識別成功率を保証するものではありません.
CORE-ReID V2は,高精度な大規模モデルだけでなく,ResNet18・ResNet34など軽量なモデルにも対応します.計算量と認識精度のバランスを用途に合わせて選べます.
| バックボーン | パラメータ数 | GFLOPs / 画像 | 速度(FPS) |
|---|---|---|---|
| ResNet18 | 12.97 M | 1.18 | 254 |
| ResNet34 | 23.08 M | 2.35 | 185 |
| ResNet50 | 46.62 M | 5.10 | 144 |
| ResNet101 | 65.61 M | 7.58 | 87 |
| ResNet152 | 81.26 M | 10.61 | 61 |
論文 Table 14.画像サイズ128 × 256,Quadro RTX 8000 GPU 1台,バッチサイズ1の測定値.実際の端末・環境での速度は異なります.
新しい撮影環境で個別の正解ラベルを大量に用意せずに,人物や車両をより正確に照合するための技術です.映像検索や長時間の対象追跡を支える基盤技術として期待されます.
ただし,学習時に生成する仮ラベルの品質に影響されるため,混雑した場面や極端に異なる環境での信頼性には改善の余地があります.人・車両以外の対象への一般化や実環境での検証も今後の課題です.
Trinh Quoc Nguyen, Oky Dicky Ardiansyah Prima, Syahid Al Irfan, Hindriyanto Dwi Purnomo, Radius Tanone
AI Sensors, 1(1), Article 4 (2025).